AIGC音视频模型本地部署
AI创作已成为趋势,但模型本地部署仍有挑战,本项目致力于解决这些挑战,提供高效易用的本地AIGC音视频模型部署方案
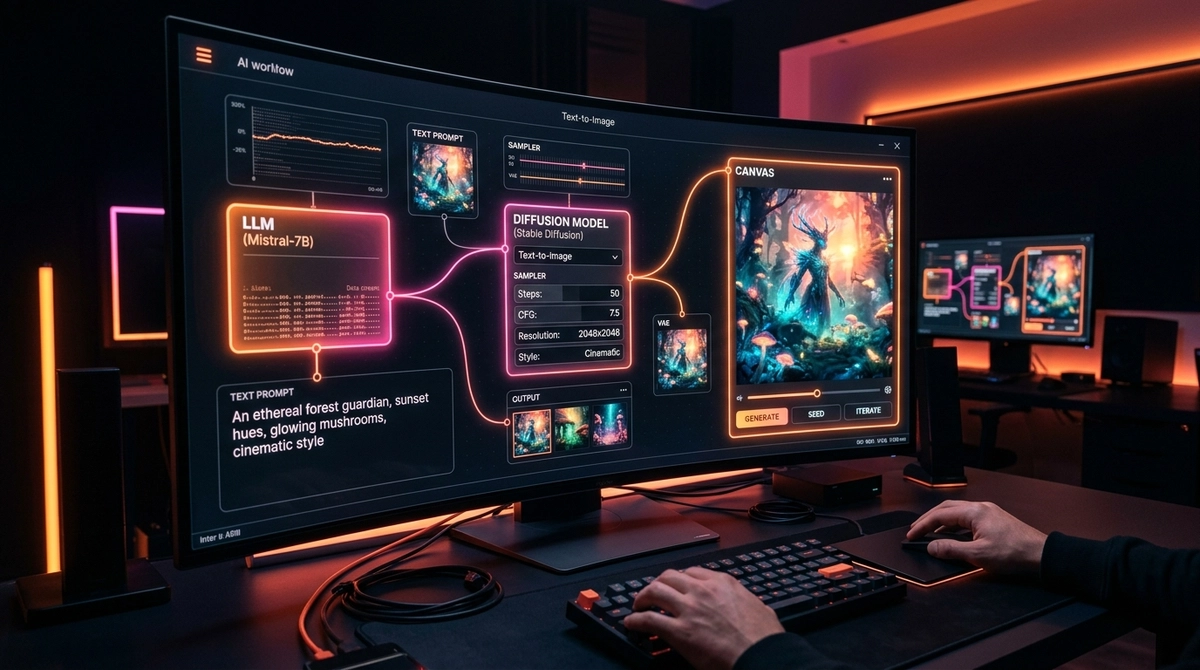
🛠️ 技术栈与选型:
PyTorchCUDAComfyUILLM APIQuantization
💡 项目背景与初衷
随着生成式人工智能(AIGC)从“文生图”向“文生视频、音频克隆、数字人协同”多模态演进,越来越多的创作者与小型设计/影视工作室希望将模型本地化私有部署:
- 🔒 数据完全私有:敏感素材与商业创意无需上传云端;
- 💰 零持续订阅费用:摆脱昂贵的在线 API 调用额度限制;
- 🎛️ 极致定制与控制力:可深度接入自定义 LoRA、ControlNet 与精准控制节点。
然而,开源前沿音视频模型部署面临着 CUDA 驱动与 Python 环境冲突、消费级显卡显存瓶颈 (CUDA OOM)、跨节点依赖地狱 等诸多工程挑战。本项目致力于攻克这些痛点,提供开箱即用、显存优化、高鲁棒性的端到端本地 AIGC 音视频模型部署与定制交付方案。
🏛️ 支持部署的模型与框架
| 模块类型 | 核心框架与前沿模型选型 |
|---|---|
| 🎛️ 调度工作台 | ComfyUI 节点化全流程工作流 |
| 🎨 文生图模型 | Z-image-Turbo · Kera-2 Turbo |
| 🎬 图生视频模型 | Minimax h3 · LTX 2.3 |
✨ 核心交付能力与工程亮点
1. 消费级显卡极限制程与显存优化
- 量化方案适配:针对 8G / 12G / 16G 消费级显卡(如 RTX 4060Ti / 4070 / 4080 / 3090),定制集成 FP8 / GGUF / NF4 量化版本模型,大幅压缩显存驻留体积。
- 显存分块与动态 Offload:配置 Block-wise 显存交换与 CPU-GPU 动态卸载策略,结合 FlashAttention-2 与 xFormers 显存加速加速库,避免生成高分辨率长视频时发生 CUDA 内存溢出。
2. 模块化 ComfyUI 音视频自动化流水线
- 端到端音视频合成链路:设计定制节点流,实现「LLM 剧本分镜生成 -> 角色语音克隆 (TTS) -> 关键帧扩写 (Flux/SD) -> 镜头运动视频生成 (Video Model) -> 对口型渲染 (Lip-sync)」全流程串联。
- 一键式预设与参数预置:为不同画风、视频帧率(24/30/60 FPS)和画面比例封装独立工作流模板,降低非技术创作者的使用门槛。
3. 环境隔离与便携式交付方案
- 便携式一键包封装:采用独立虚拟环境(Embedded Python)结合锁定依赖清单(Pinned Dependencies),彻底规避 Torch、Torchvision 与 CUDA 版本错位问题。
- 自动模型权重分流管理:设计智能下载与缓存分流脚本,支持多模型共享基座权重,避免重复占用本地固态硬盘空间。
🛠️ 典型攻关难点与解决方案
难点 1:长视频与高分辨率生成过程中的 CUDA OOM(显存溢出)
问题:视频扩散模型在时间轴注意力(Temporal Attention)计算时,显存消耗呈非线性暴增,16GB 显卡极易报错闪退。
解决方案:引入 VAE 分块切片编解码 (Tiled VAE) 与模型层级卸载机制(Model Sequential CPU Offload),在损失不足 1% 画面精度的前提下,将显存峰值降低 45% 以上,使 12GB 显存即可稳定输出 720P/1080P 连贯视频。
难点 2:开源 ComfyUI 自定义节点生态的冲突与版本混乱
问题:音视频工作流往往需要同时引入 20+ 个社区自定义节点,各节点对特定库(如 transformers, torchaudio, numpy)版本要求各异,导致启动崩溃。
解决方案:对核心底层算子进行修补并二次封装为兼容中间层,建立经过千次测试的依赖基线版本锁定策略,实现多模态复合节点的无冲突共存。
🎯 落地价值与应用场景
🎬 AI 短剧与自媒体视频创作:快速生成高质量镜头空镜、叙事过场与角色对白;
🎙️ 数字人与虚拟播音:高保真音色克隆与口型同步播报;
🎨
电商与产品视觉设计:本地快速生成产品 3D 旋转镜头与动态广告特效。